MongoDB Schema 設計系列 (七):Computed Pattern 計算模式優化高頻與重載查詢
Computed Pattern (計算模式) 是用來解決很頻繁使用,但 Loading 很重或運算較久的 query 所造成的效能與效能瓶頸問題。
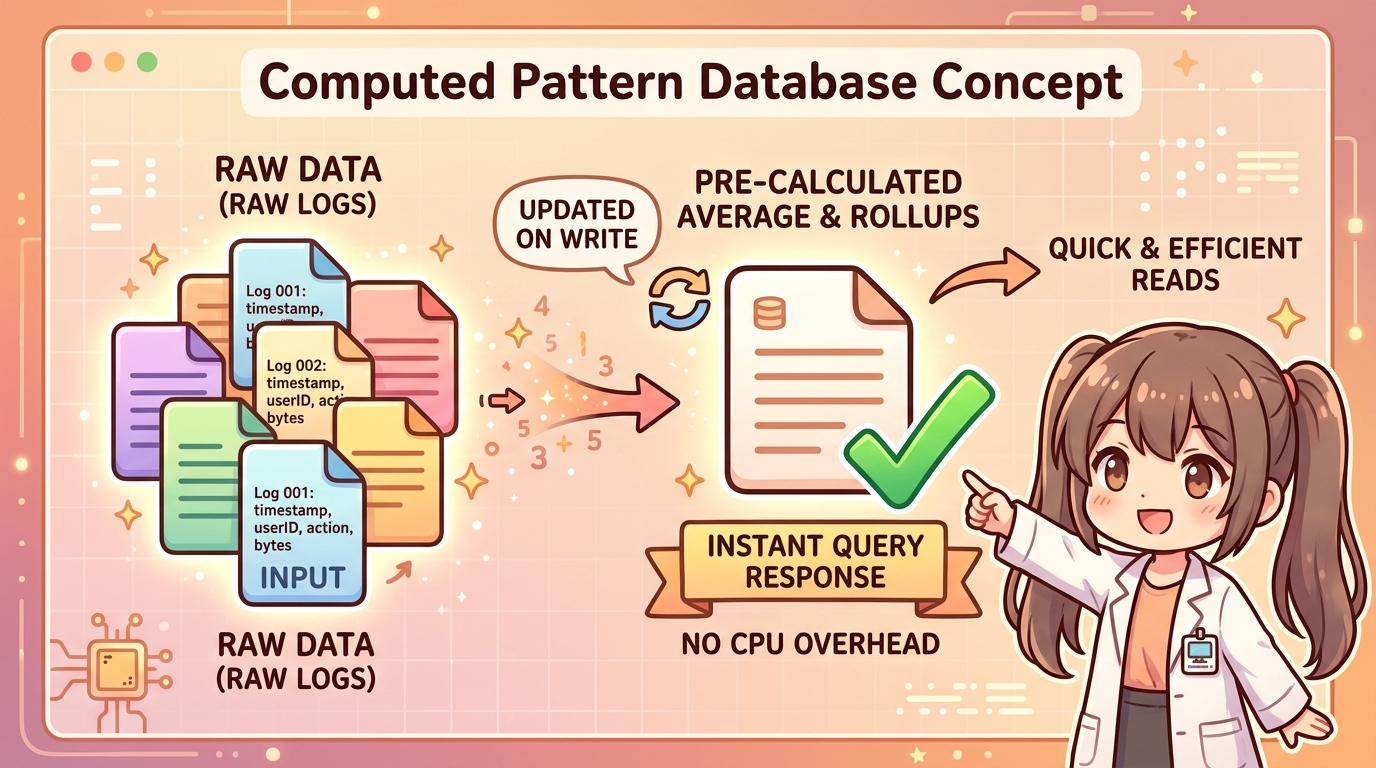
作法非常簡單直覺:就是預先算好結果並直接儲存起來,用寫入時的輕微代價換取讀取時的極致效能。
常見的 Computed Pattern 三大應用情境
到底怎麼樣的運算才算 Loading 重或運算較久,而適合套用 Computed Pattern 呢?以下介紹三種實戰最常見的類型:
1. 數學/統計聚合運算 (Mathematical Operations)
例如:在後台或首頁有個 query 需要頻繁回傳「最新 100 筆感測器資料的平均值」。
如果採用傳統方式,每次讀取請求進來時,資料庫的步驟是:
- 查詢所有相關資料。
- 按照時間欄位排序。
- 取得最新 100 筆資料。
- 在記憶體中進行加總並除以 100 計算平均。
這個查詢每一次都會造成大量的硬碟 I/O 以及 CPU 排序與加總開銷。如果我們套用 Computed Pattern,在每一次「寫入新感測資料」時,就在背景或 Data Access Layer 順便算好最新的平均值並直接更新到一個快取 document 內。這樣讀取時只需要直接 GET 該數值,便能省去每一次的重複計算。
2. 讀取扇出優化 (Fan Out On Read)
這是指一個查詢需要同時從多個不同的來源 (多個 collections 或 documents) 抓取資料再進行運算與拼裝,導致使用者等待很久的問題。
以影音平台的頻道訂閱為例:
- Fan Out On Read (讀取時計算):每次使用者登入首頁時,系統才去撈取他訂閱的 50 個頻道的最新影片,並將這 50 個影片依照上架時間合併排序。這會造成巨大的多表查詢負擔與時間延遲。
- Fan Out On Write (套用 Computed Pattern):每當某個頻道發布新影片時,系統主動將該影片的 ID 與基本資料寫入到所有「訂閱該頻道的使用者」的「最新訂閱影片 Inbox 列表」中。當訂閱者登入首頁時,直接從他個人的 Inbox 文件撈取資料,達成秒開首頁的極致體驗。
3. 層級累加運算 (Roll Up Operation)
Roll Up Operation 是指將資料從不同的細緻度 (Granularity) 來進行歸納與加總。
例如:假設你在全台灣經營自有品牌連鎖店。你可以看:
- 各分店月營收
- 各縣市月總營收
- 北中南區域月營收
- 全台總月營收
除了最底層的「各分店營收」是原始交易紀錄外,其餘縣市、區域、全台營收全部都是由下方層級的營收累加加總上來的。如果每次管理者看儀表板時資料庫都要當場執行 Group & Sum 累加,速度會極慢。
透過 Computed Pattern,我們可以在每日結帳時,自動將分店營收往上計算,並直接將累加結果儲存至 county_revenue、region_revenue 與 national_revenue collection。管理者讀取儀表板時便能瞬間載入。
優點與缺點權衡
- 優點:能夠極大地節省資料庫的 CPU 計算時間、降低磁碟 I/O,並將讀取回應時間縮短至毫秒級。
- 缺點:這是一個非常容易被濫用的 Pattern。因為它實作起來太直覺簡單,且不像 Duplication/Embedding 那樣有嚴重且複雜的資料雙向一致性問題(我們只需要在資料寫入或更新時,單向去計算並覆寫結果)。
[!WARNING] 請在確認該查詢的讀寫比例極高 (讀極多、寫極少),且實時計算確實已造成資料庫明顯 Loading 之後再行導入,避免讓系統的寫入邏輯變得過於臃腫。