DatabaseMongoDBData Modeling
MongoDB Schema 設計系列 (七):Computed Pattern 計算模式優化高頻與重載查詢
這是 MongoDB 資料建模系列的第七篇文章,介紹 Computed Pattern (計算模式)。當系統面臨高頻率且計算繁重的 Aggregation 查詢時,說明如何利用預先計算並貯存結果的策略,省下 CPU 運算資源並達成瞬間響應。
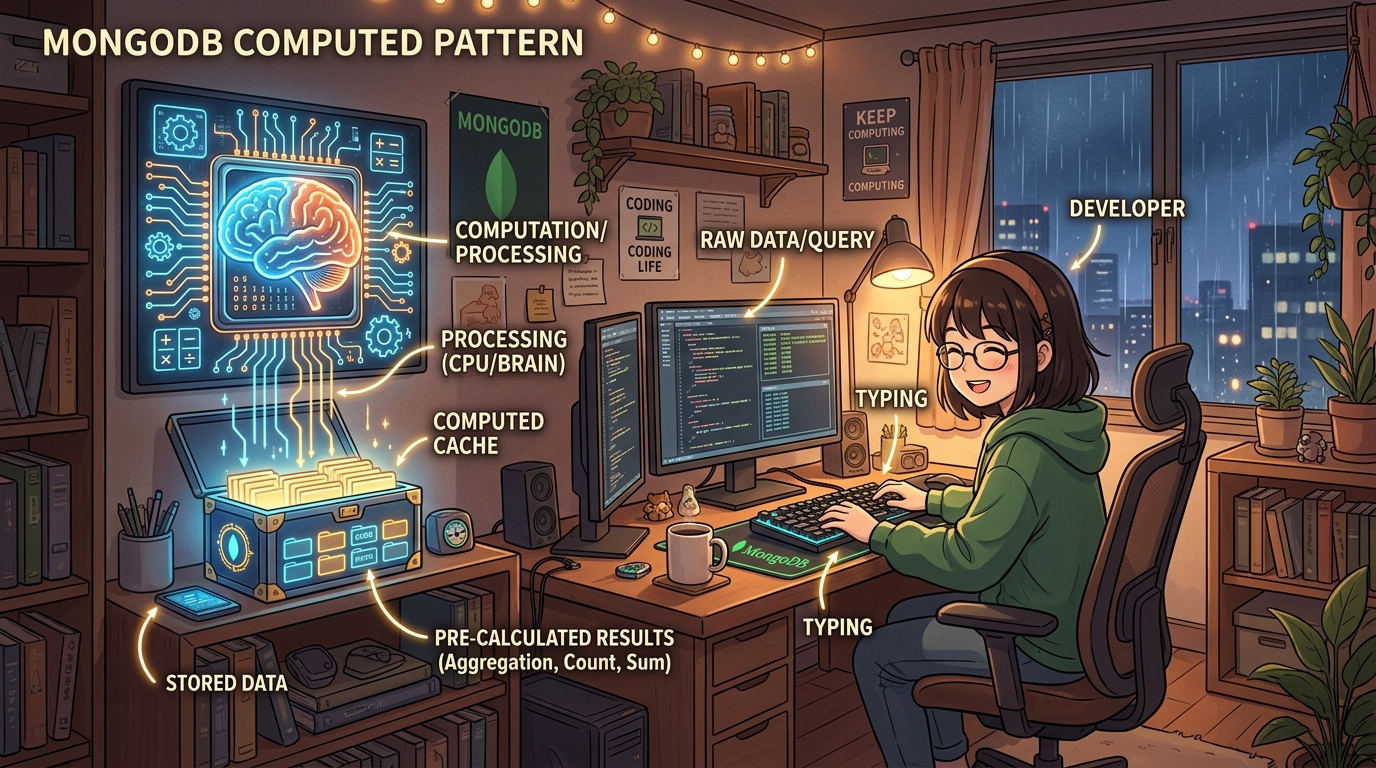
這是 MongoDB 資料建模系列的第七篇文章,介紹 Computed Pattern (計算模式)。當系統面臨高頻率且計算繁重的 Aggregation 查詢時,說明如何利用預先計算並貯存結果的策略,省下 CPU 運算資源並達成瞬間響應。
閱讀全文 →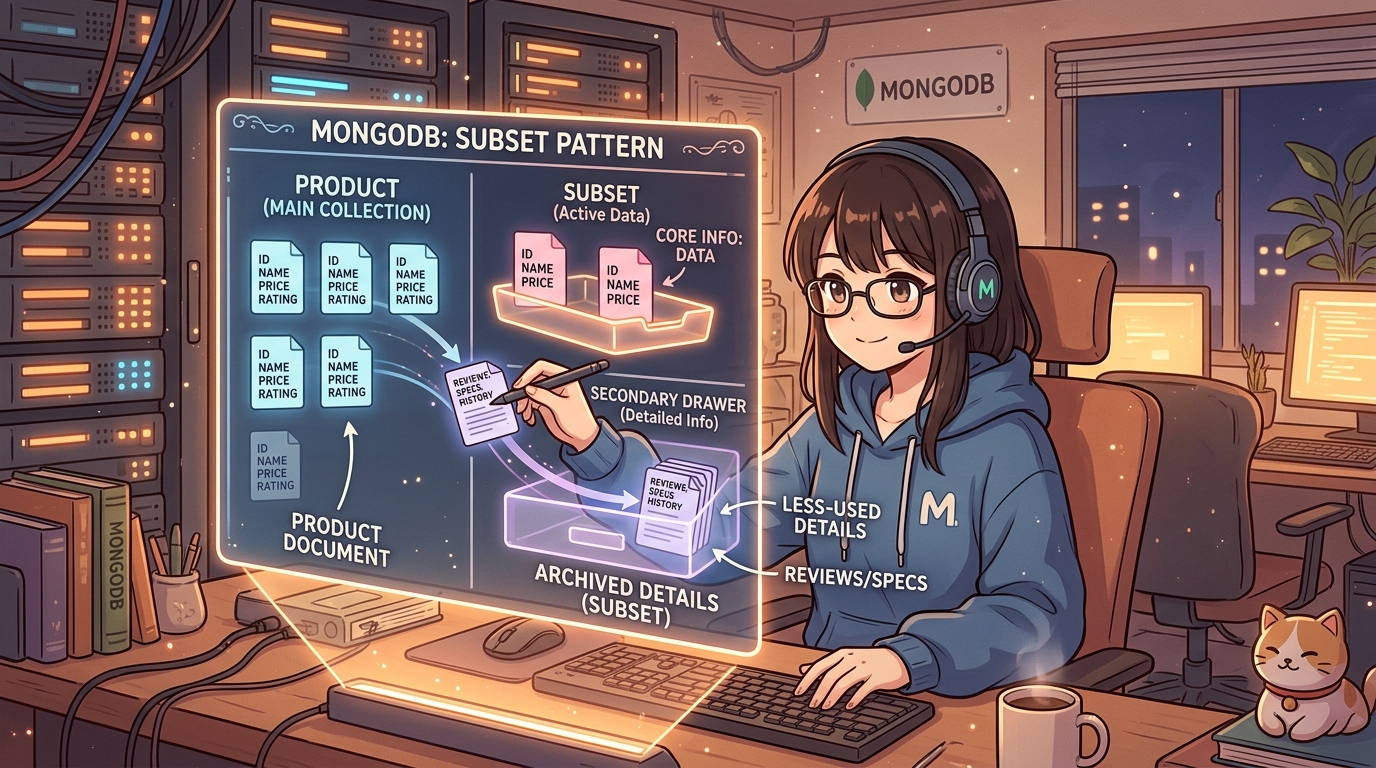
這是 MongoDB 資料建模系列的第六篇文章,介紹 Subset Pattern (子集模式)。當單一 Document 資料量過大且無法全部塞入記憶體時,說明如何藉由拆分常用與不常用欄位,減少記憶體與磁碟間的分頁交換頻率,顯著提升讀取效能。
閱讀全文 →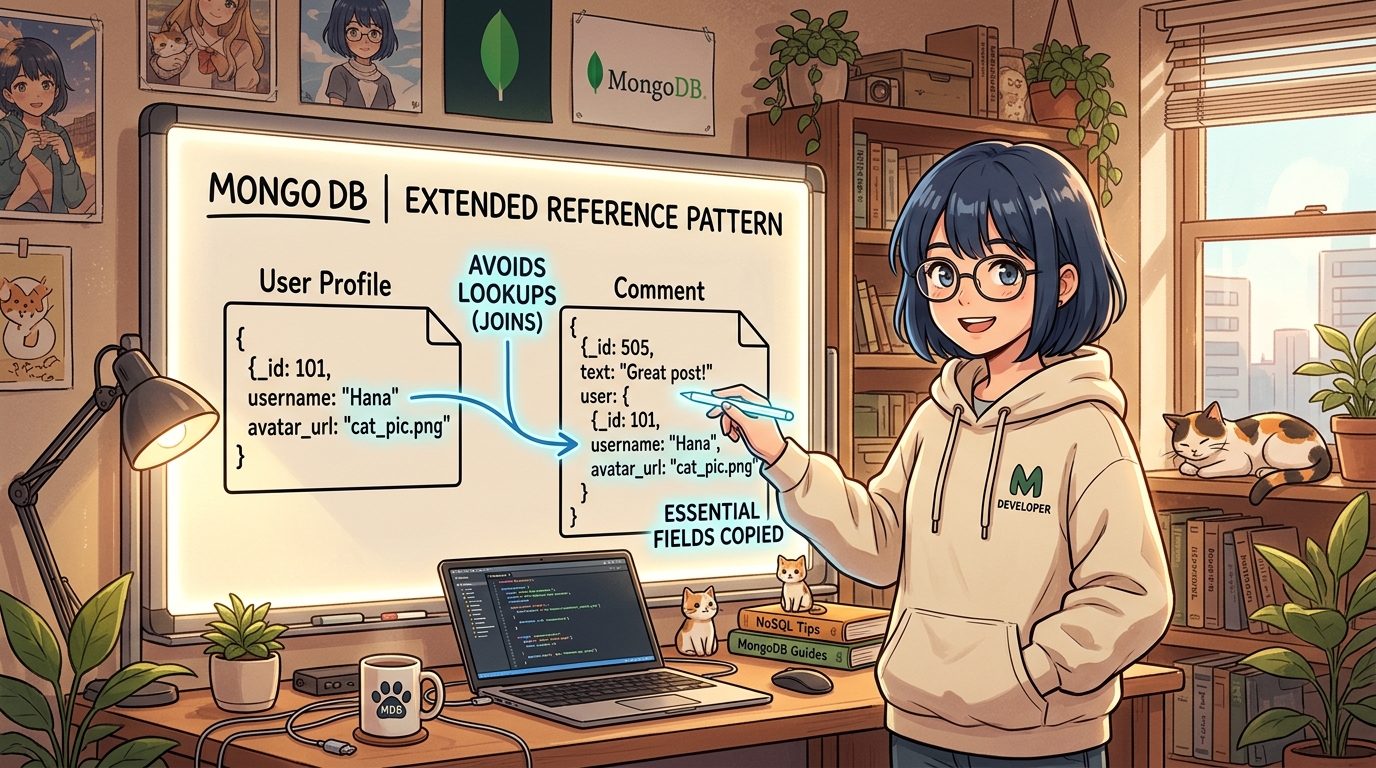
這是 MongoDB 資料建模系列的第五篇文章,介紹當系統在多個 Collection 之間頻繁執行 $lookup 整合資料時,如何利用 Extended Reference Pattern (延伸參照模式) 透過適度重複欄位進行 Embedding 來優化讀取效能。
閱讀全文 →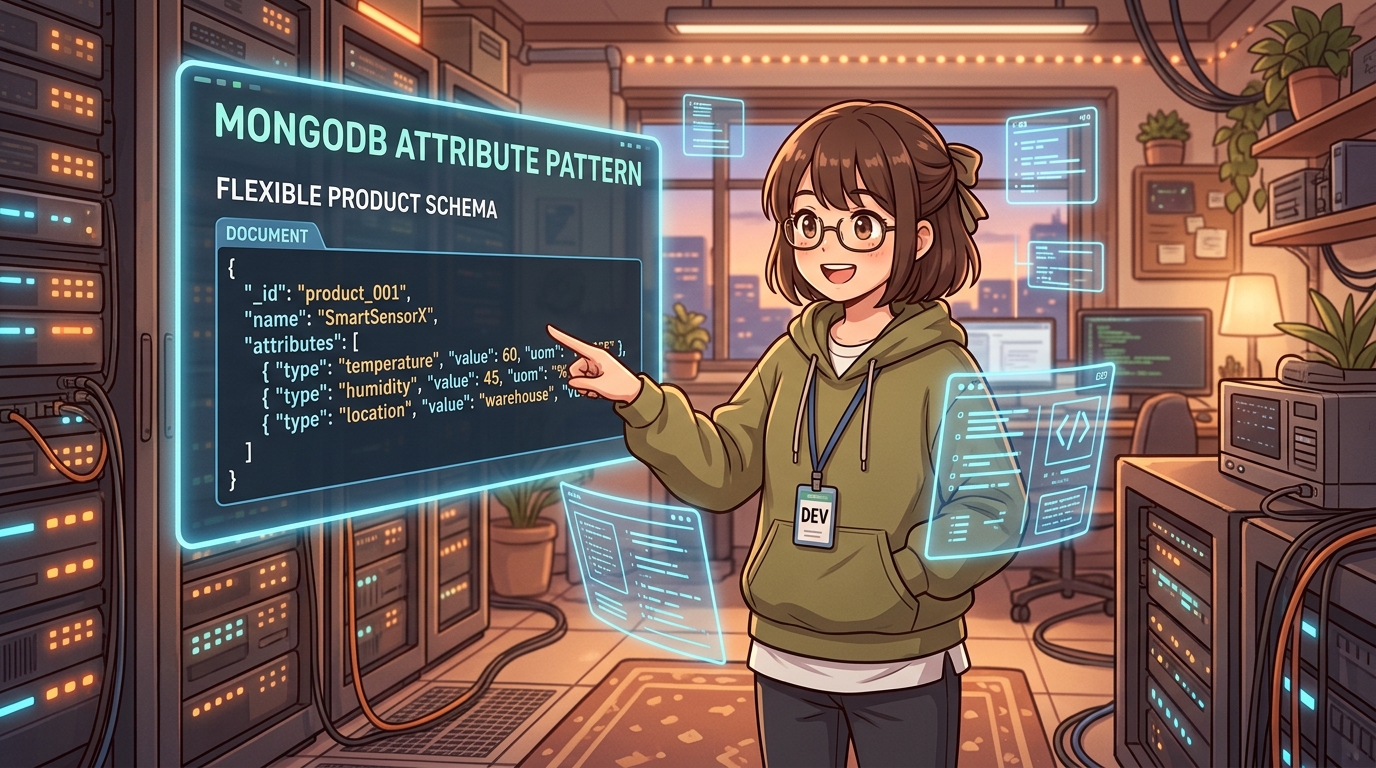
這是 MongoDB 資料建模系列的第四篇文章,介紹我最常用且最喜歡的 Attribute Pattern。透過貼文 Ownership 與工廠機器量測訊號兩個實戰案例,說明它如何簡化 Index 建立與 Data Access Layer 設計。
閱讀全文 →
這是 MongoDB 資料建模系列的第三篇文章,介紹導入 Design Pattern 解決問題時,隨之而來的 Duplication、Staleness 和 Referential Integrity 三大妥協與設計權衡。
閱讀全文 →
這篇深入介紹不同 Entity 之間如何建立關聯(Embedding 與 Referencing),以及 1 to 1、1 to many、many to many 關係的設計權衡。
閱讀全文 →
這是 MongoDB 資料建模系列的第一篇文章,整理自我的 MongoDB University 上課筆記,分享我如何看待資料庫 Schema 的設計工作流與核心設計原則。
閱讀全文 →
基於 279,712 筆房源數據,深度剖析巴黎、紐約、雪梨、羅馬等全球 10 大城市的短期租賃共享經濟。
閱讀全文 →