DatabaseMongoDBData Modeling
MongoDB Schema 設計系列 (五):Extended Reference Pattern 延伸參照模式剖析
作者:Simon Cho•
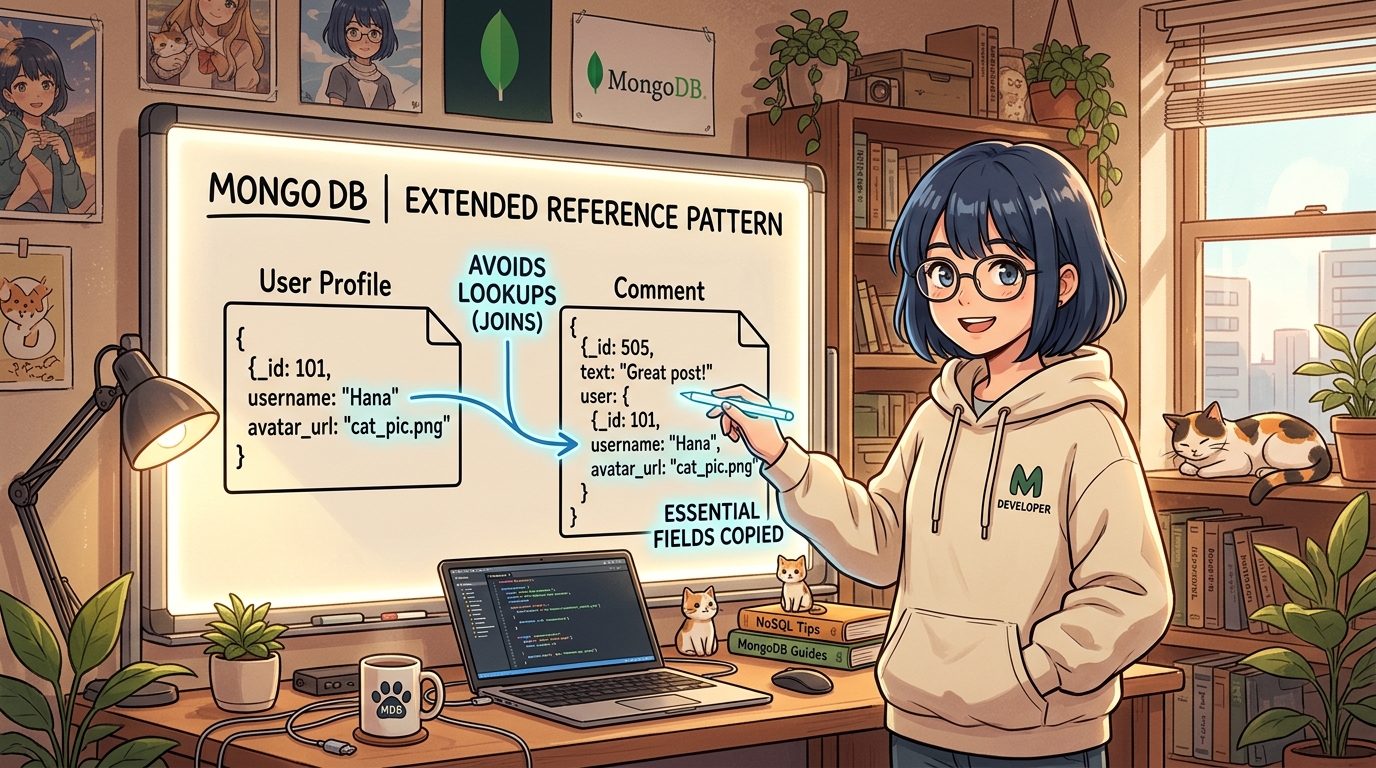
在之前的文章中有提到,越常一起出現的資料盡量放在一起,但還是有機會遇到新的 use case 時,發現資料分開放。當我們發現已經要在多個 collection 之間到處 $lookup 來整合資料,而且消耗大量資源 and 時間時,可以考慮使用 Extended Reference Pattern (延伸參照模式)。
做法也滿直觀的,既然要到處 $lookup 那何不一開始就直接 duplicate 需要的資訊在同一個 collection?簡單來說就是透過局部 Embedding 來彌補 Referencing 的不足之處。
Extended Reference 範例情境
例如網購訂單在資料庫中必須要有:
- 買家姓名、電話及送貨地址
- 各商品的商家姓名及電話
- 各商品的品名、數量及單價
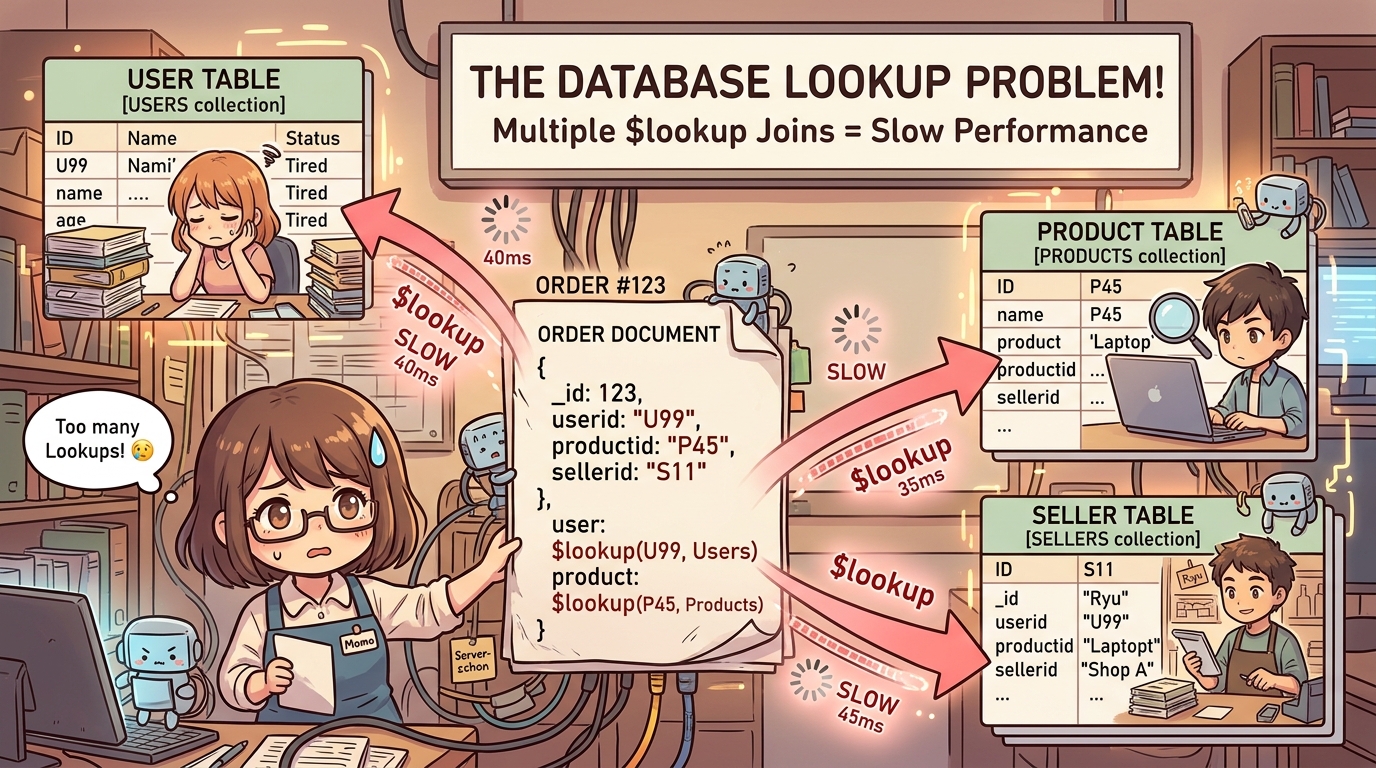
也就是說,一筆訂單資料其實包含三種類型的資料:買家、商品資訊、與商家 (賣家) 資訊。
如果這些類型的資料都是完全透過單純的 reference (參照) 進行關聯,那麼在渲染訂單頁面時,系統勢必要透過 3 次 $lookup 來跨 collection 取得完整資料。隨著訂單量增加,查詢次數越多,資料庫查詢效能會呈線性下滑。
解決方案
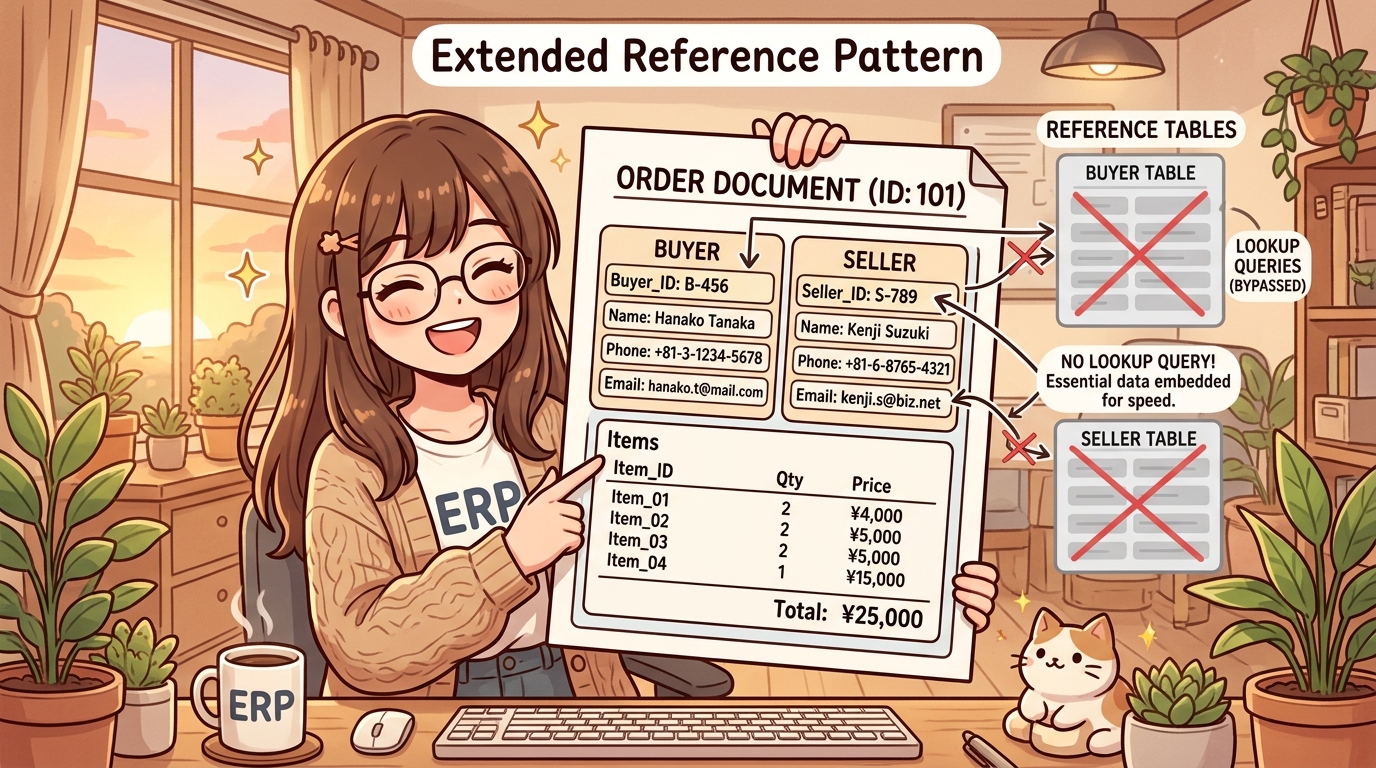
使用 embedding 取代單純的 reference 來進行資料關聯,但並不是把整份實體資料都嵌入到訂單資料中(否則會快速觸及 16MB 的上限且浪費硬體空間)。
例如:
- 在訂單資訊中,我們只需要買家姓名、電話及送貨地址,買家其他的資訊如性別和生日,就絕對不需要被嵌入到訂單。
- 同樣地,商家資訊我們只需要其姓名及聯絡電話,商家的完整實體地址及負責人等欄位就不會嵌入到訂單。
我們只把「高頻率需要與訂單一同呈現的少數核心欄位」延伸複製(Extended Reference)過來嵌入。
使用條件與權衡
回想一下我們做了什麼事?我們透過 duplicate (資料重複複製) 資訊並嵌入到 document 之中。這個行為本質上是透過空間換取時間 (讀取速度),它的代價是我們需要額外維護資料的一致性 (Consistency)。
因此,建議在滿足以下兩個條件時,再評估導入 Extended Reference:
- 讀取效能的場景價值,遠高於寫入/同步資料的代價。
- 被複製的欄位資訊,異動頻率非常低。如果被複製的資料變動頻率很高,那就代表系統必須頻繁花費心力去多表同步,反而會消耗更多資料庫的 I/O 資源。