MongoDB Schema 設計系列 (六):Subset Pattern 子集模式以優化記憶體使用
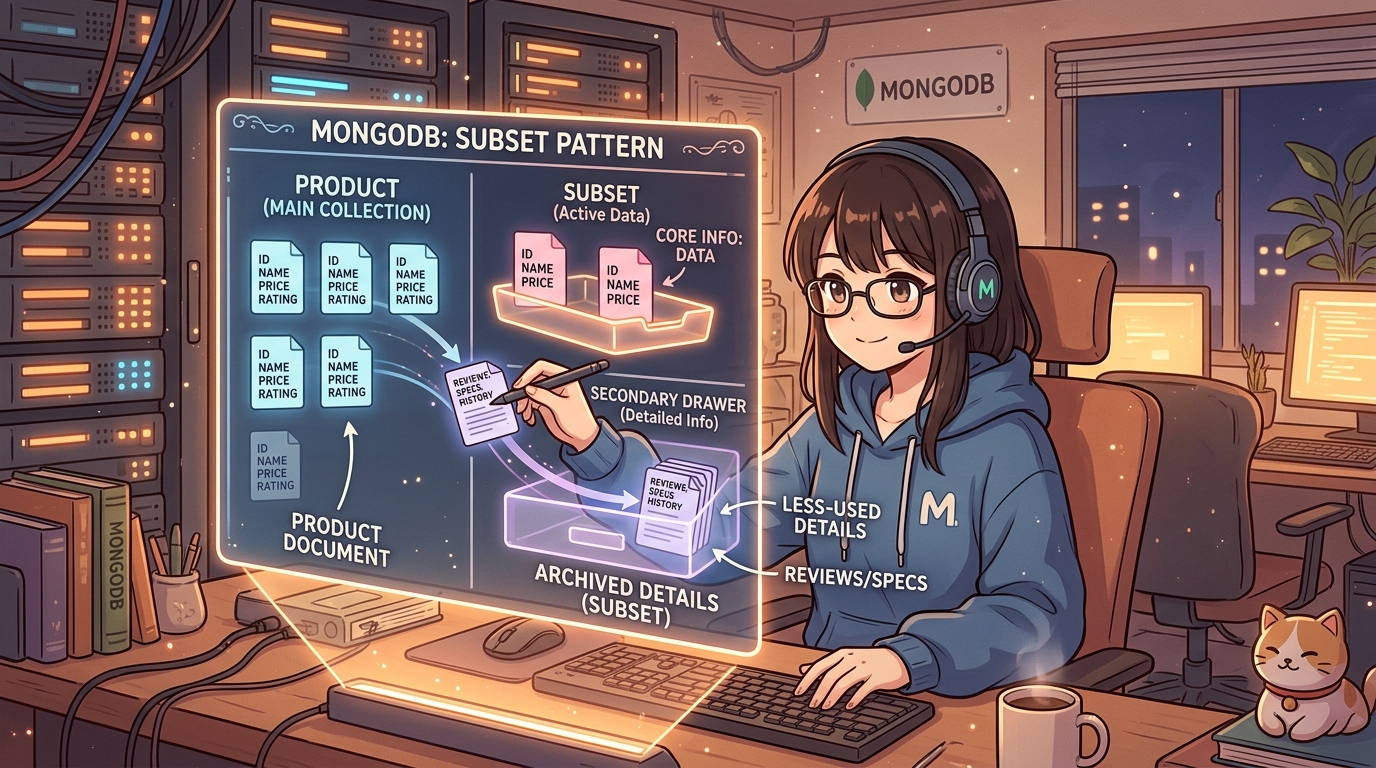
MongoDB 資料建模的核心原則是「將常一起出現的資料放在一起」。但如果資料量過大、單個 document 包含太多欄位,導致工作集 (Working Set) 大到無法完整放進記憶體時,資料庫就會需要頻繁地從硬碟將資料載入 RAM (產生 Page Fault)。這會導致 query 的效能急劇下降,Subset Pattern (子集模式) 就是為了解決這個硬體資源限制下的效能問題。
Subset Pattern 的概念
Subset Pattern 的思考點非常直觀:
那些「常一起出現的資料」,真的每一次查詢都完全需要一起出現嗎?
有沒有可能其中一部分的欄位(例如:商品的所有歷史評論、電影幕後所有特技美術人員名單),只有在 5% 的特定情況下才會用到,而其他 95% 的主要流量只需要基本屬性?
如果是的話,我們就可以將這部分低頻率使用的欄位拆分出去,另行存放在另一個 collection 中。
具體做法與範例
Subset Pattern 主要是「用時間換取空間 (記憶體空間)」的策略。做法是將一個 collection 內的欄位區分為:
- 常用欄位:保留在原 Collection (Main Collection)。
- 低頻欄位:拆分到一個新的「詳細資訊」Collection。
[!TIP] 這樣做的好處是:我們可以確保在有限的實體記憶體空間內,RAM 快取的大部分都是高度活躍的「常用資料」,進而顯著減少硬碟與記憶體之間進行資料交換 (Paging) 的頻率,以此提升熱點查詢的吞吐量。
以電影資料庫 (IMDB) 為例
假設原本我們存的電影資料格式很龐大,包含了所有的幕後工作人員名單:
{ // movie
  "title": "Avengers: Endgame",
  "release_date": "2019-04-26",
  "genre": "Action/Sci-Fi",
  "director": "Russo Brothers",
  "actors": ["Robert Downey Jr.", "Chris Evans"],
  "box_office": "$2.798 Billion",
  "distributor": "Walt Disney",
  "shooting_location": "Atlanta, Georgia",
  "stunt_crew": ["Stunt Person A", "Stunt Person B", "......"],
  "vfx_crew": ["VFX Artist A", "VFX Artist B", "......"],
  "costume_crew": ["Costume Designer A", "......"],
  "art_crew": ["Art Director A", "......"]
}
在首頁或一般列表搜尋頁面,使用者通常只想看片名、發片日期、導演與主演。幕後特技人員、服裝道具、特效人員名單只有極少數影迷會點開「完整資料頁面」檢視。但每次查詢電影,整筆巨大的 Document 都會被載入記憶體,佔用寶貴的快取空間。
套用 Subset Pattern 後,我們可以將其拆分為兩個 collection:
{ // movie (常用子集)
  "_id": ObjectId("m1"),
  "title": "Avengers: Endgame",
  "release_date": "2019-04-26",
  "genre": "Action/Sci-Fi",
  "director": "Russo Brothers",
  "actors": ["Robert Downey Jr.", "Chris Evans"]
}
和
{ // movie_detailed (完整詳細資訊)
  "_id": ObjectId("md1"),
  "movie_id": ObjectId("m1"), // 關聯至主 Movie Collection
  "box_office": "$2.798 Billion",
  "distributor": "Walt Disney",
  "shooting_location": "Atlanta, Georgia",
  "stunt_crew": ["Stunt Person A", "Stunt Person B"],
  "vfx_crew": ["VFX Artist A", "VFX Artist B"],
  "costume_crew": ["Costume Designer A"],
  "art_crew": ["Art Director A"]
}
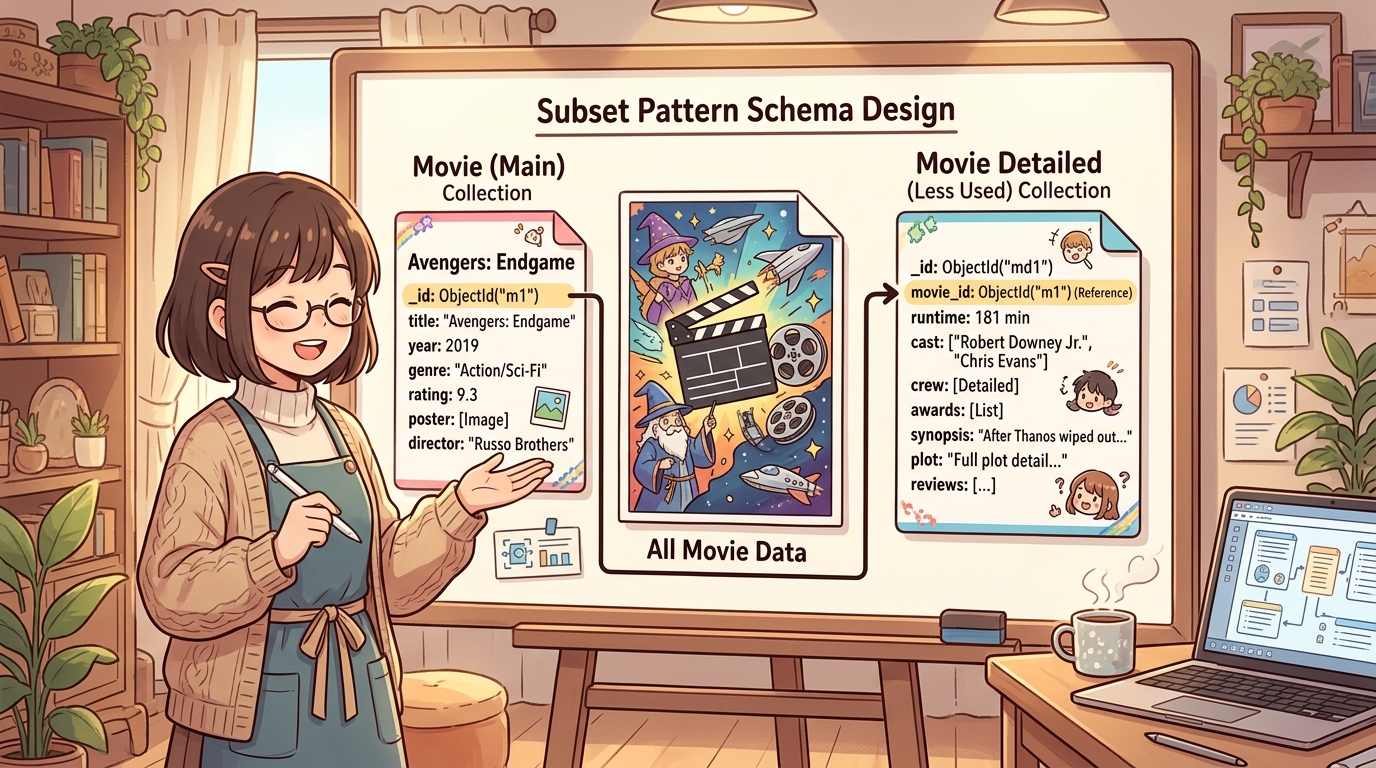
我們將不常用的幕後團隊名單欄位移到 movie_detailed 中,並透過 movie_id (或電影名稱與發片日期) 進行關聯。只有當使用者點擊「完整資訊」頁面時,系統才去查詢 movie_detailed。
這能有效瘦身主資料庫的 Document Size,確保 Working Set 的記憶體被發揮到最高效益!