Javascript 在 Nodejs 的執行過程
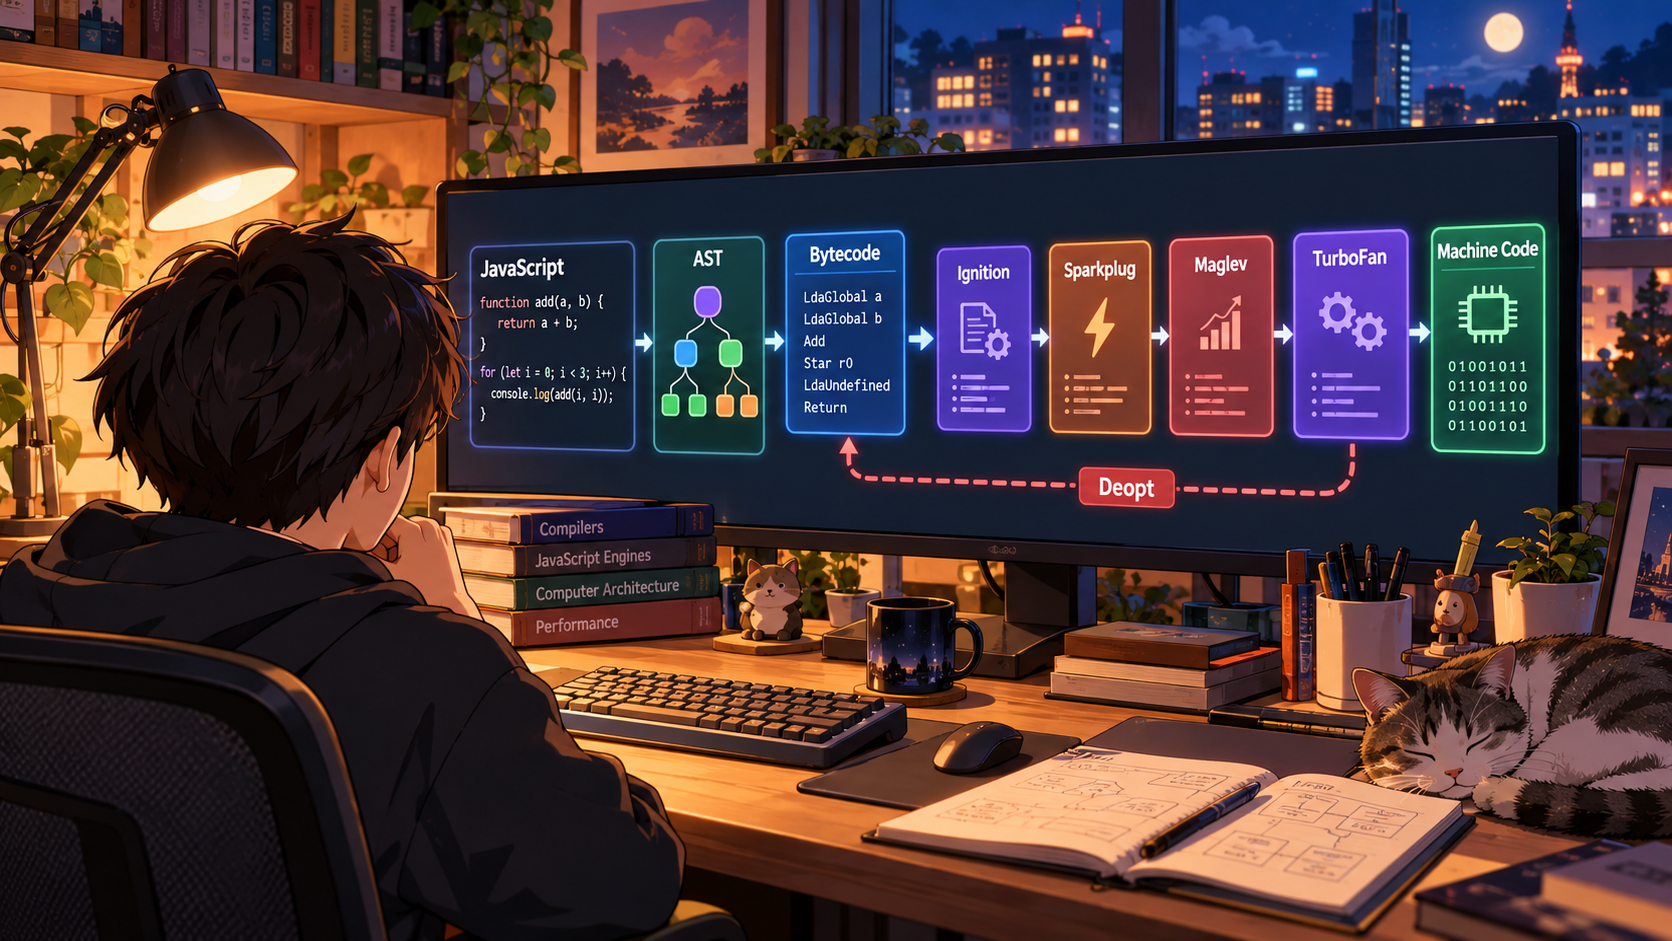
之前在排查 MongoDB Transaction Timeout 時,發現有一段 JavaScript 遞迴處理大量 object,CPU 時間比原本想像中長很多。那時候只知道「這段 JS 很慢」,但不太清楚 V8 到底怎麼決定一段 code 能不能跑得快。
後來回頭看 V8 的 compilation pipeline,才把中間幾個名詞串起來:Hidden Class、Inline Cache、hot path,還有為什麼有些 function 明明跑了一段時間,突然又退回比較慢的路徑。
Parsing
JavaScript source code 不是 CPU 可以直接執行的格式。V8 會先 parse 成 Abstract Syntax Tree(AST),再編譯成 bytecode。
bytecode 是後面 Ignition Interpreter 要執行的指令格式。這一段算是每份 JavaScript 都會先經過的入口。
Ignition Interpreter
Ignition Interpreter 會執行 bytecode。執行到讀取 object property 時,例如:
function getName(user: { name: string }) {
  return user.name;
}
V8 得知道 name 在這個 user object 的哪個記憶體位置。它不會只看 property 名稱,還會看這個 object 的 Hidden Class。
Hidden Class
Hidden Class 可以理解成 V8 對 object 結構的內部紀錄:有哪些 property,以及它們加入的順序。
const first = { name: 'Simon', age: 30 };

const second: { age?: number; name?: string } = {};
second.age = 25;
second.name = 'Mary';
first 和 second 最後都有 name、age,但 property 加入順序不同,V8 會把它們視為不同 shape,也就不會共用同一個 Hidden Class。
所以處理同一批資料時,讓 object 維持一致的 property 集合和建立順序,比較容易讓 V8 走到它已經熟悉的路徑。這不是叫人為了效能硬把所有 code 寫得很僵;只是如果一個 hot path 一直在吃結構飄來飄去的 object,代價真的會累積起來。
Inline Cache
每次都從 Hidden Class 推算 property offset,成本還是有點高。Ignition 查過一次後,會把「這個 Hidden Class 的 name 在哪個 offset」存進 Inline Cache。
下次再遇到相同 Hidden Class,就可以直接用 cache 找到位置。不同 shape 陸續出現時,cache 也能先記住幾種常見情況。
但 shape 多到一定程度後,這個 access site 會變成 megamorphic,V8 不再適合繼續為每種 Hidden Class 維護快取,property lookup 又得走比較一般的路徑。
Hot Path
function 被執行時,V8 會記錄它的執行狀況。跑得很頻繁、資料型態也夠穩定的路徑,就是常講的 hot path。
當一段 bytecode 熱到某個程度,V8 會嘗試把它編譯成 machine code。這樣可以直接把某些已知的 property offset、型別檢查和控制流程放進機器碼裡,少掉 Interpreter 執行 bytecode 的成本。
Sparkplug、Maglev、TurboFan
V8 不會一開始就花很多時間做最重的最佳化。它有分層的 JIT compiler:Sparkplug、Maglev、TurboFan。
前面的層級編譯快,最佳化相對保守;後面的層級能做更多假設和最佳化,但編譯成本也更高。V8 會根據 function 的熱度和蒐集到的執行資訊,決定要不要往上走。
這也是為什麼短命、只跑一次的 code 通常不需要特別擔心 JIT;先把真正反覆執行、而且佔 CPU 的路徑找出來比較實際。
De-optimization
最佳化過的 machine code 並不是沒有條件的。例如它可能假設傳進來的 object 都有同一個 Hidden Class。
function getName(user: { name: string }) {
  return user.name;
}

getName({ name: 'Simon' });
getName({ name: 'Mary' });
getName({ name: 'Kevin', role: 'admin' });
前兩次的 shape 一樣,後一次多了 role。如果 machine code 前面的 guard 發現輸入不符合原本的假設,V8 會放棄這份 machine code,交回 Ignition 用 bytecode 執行。這件事就是 de-optimization。
de-opt 不是錯誤,也不代表只要發生就要立刻重構。它是 V8 在保證結果正確的前提下,撤回一個已經不適用的最佳化。之後 function 的 counter 會重新累積,資料又穩定下來的話,還是有機會再次被編譯。
寫 code 時會注意的地方
如果是會被大量呼叫的資料轉換或迴圈,我現在會先看傳進去的 object 是不是同一種 shape:
- 建立同類 object 時,property 順序盡量一致。
- 不要在 hot loop 裡隨意替部分 object 補上不同的 property。
- 能先初始化的欄位就先初始化,避免同一批資料有些欄位晚很久才出現。
- 不要只因為這些規則就過度設計;先用 profiling 確認 JavaScript 真的是 CPU bottleneck。
我一開始把 V8 想成「把 JavaScript 編譯成 machine code」這麼簡單,後來才知道中間其實一直在觀察 code 的行為、做假設、再根據實際輸入撤回假設。Hidden Class 和 Inline Cache 讓我比較能理解,為什麼看起來差不多的兩種 object 寫法,在重複執行的情境下可能走到不一樣的成本。